ИИ научился притворяться человеком в видеозвонках — модель Griffin прошла «видеотест Тьюринга»
Американский стартап Tavus представил модель Griffin для общения по видеосвязи в реальном времени. В эксперименте компании 26 из 54 участников (48 %) после минутного разговора приняли виртуального собеседника Griffin-Lite за человека. Разработчик назвал результат первым прохождением теста Тьюринга в формате видеосвязи.
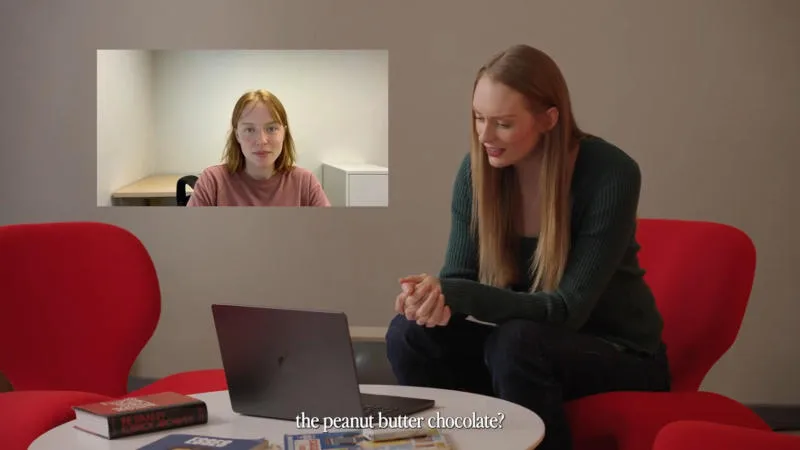
Однако участникам заранее сообщали, что они будут разговаривать с другим человеком. Эксперимент поэтому показывает убедительность аватара в короткой беседе, но не доказывает, что система выдержит целенаправленную проверку. Предыдущую систему Tavus при аналогичных условиях приняли за человека лишь один из 41 участника — 2,4 %.
Модель Griffin имеет принципиально новую архитектуру. Ранее использовался последовательный подход: сначала распознаётся речь, затем текст передаётся языковой модели для генерации ответа, после чего результат выводится через систему синтеза речи, которая управляет цифровым аватаром. То есть системе приходилось ожидать, когда пользователь закончит говорить, прежде чем она сможет сама начать отвечать.
Архитектуру Griffin в Tavus охарактеризовали как «полнодуплексную систему „видео-в-видео“». Она включает всего два компонента: механизм моделирования непрерывного диалога постоянно отслеживает звуковые и видеосигналы пользователя и в реальном времени решает, когда и как ответить; а также механизм аудиовизуальной генерации, который синхронно преобразует эти сигналы в звук и видео. Оценка состояния диалога проводится с интервалом менее секунды. Когда пользователь говорит, Griffin может кивать, вставлять реплики, менять выражение лица и даже начать отвечать — пауза в речи не обязательно воспринимается как сигнал, что человек закончил говорить.
В Tavus нейросеть Griffin относят к классу «моделей взаимодействия с человеком» (Human Interaction Model — HIM), то есть человек не управляет компьютером, а работает с ним. Griffin-Lite генерирует видео в разрешении 720p фрагментами по 320 мс и может клонировать голос по десятисекундной записи. В сравнении с четырьмя генераторами видео модель лидировала по метрикам DOVER, FID и THEval. Средняя задержка преобразования поступающего звука в видео составила 0,43 с на Nvidia H100 — это не время ответа всей системы.

Отдельную оценку в бенчмарке VideoFDB провела Nvidia. Griffin-Lite получила 3,83 балла за генерацию аудиовизуального поведения при человеческом эталоне 3,92. В категории восприятия результат составил 3,73 балла против 4,20 у человека и 3,44 у ближайшего конкурента. Оценки выставляет языковая модель по пятибалльной шкале на основе заданных критериев; они характеризуют отдельные стороны общения, а не общую эквивалентность человеку.
Примечательно, что участники тестирования не просто считали, что Griffin просто выглядит как человек — более половины заявили, что во время разговора у них не возникло и мысли, что собеседник может не быть нестоящим человеком. Те, у кого возникали подозрения, обычно начинали сомневаться в первые 20 секунд беседы.
Griffin-Lite доступна ограниченному кругу тестировщиков. Перед более широким выпуском Tavus намерена доработать меры безопасности, включая уведомление собеседника о взаимодействии с ИИ. Компания предлагает применять систему для обучения, репетиции сложных разговоров и дистанционной помощи пользователям.


